HBM(High Bandwidth Memory, D램 다이를 수직으로 쌓아 만든 광대역 메모리) 공급이 빠듯한 이유를 “AI 서버 수요가 늘어서”로 정리하면 절반만 맞습니다. 나머지 절반은 제조 구조에 있습니다. HBM은 같은 용량을 만드는 데 범용 D램보다 훨씬 많은 웨이퍼 면적을 쓰고, 그렇게 투입한 웨이퍼가 비트로 돌아오는 비율도 낮습니다.
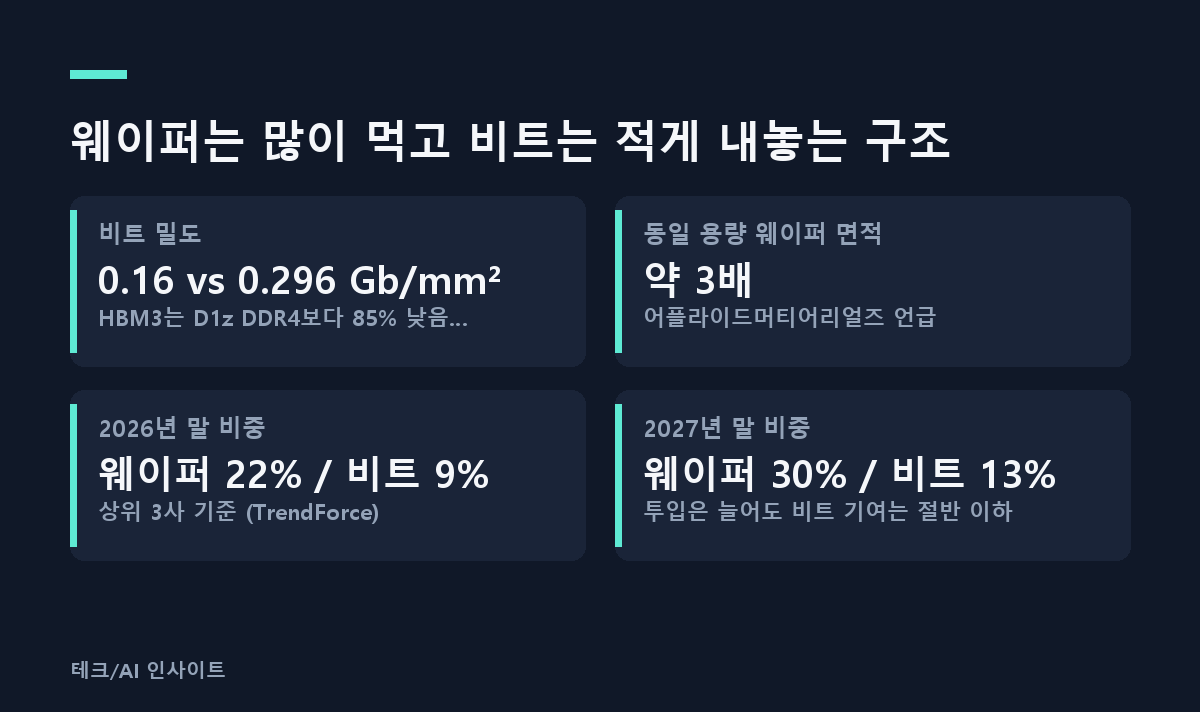
TrendForce는 상위 3사의 HBM 웨이퍼 투입 비중이 2026년 말 약 22%에 이르지만, HBM이 전체 D램 비트 공급에서 차지하는 비중은 약 9%에 그칠 것으로 전망했습니다. 웨이퍼의 5분의 1 이상을 가져가면서 비트는 10분의 1도 내놓지 못하는 구조입니다.
아래 내용은 JEDEC의 HBM 규격 문서(JESD235 계열, HBM4는 JESD270-4)와 TrendForce·SemiAnalysis 등의 공개 자료를 근거로 합니다.
한 줄 요약: HBM은 TSV가 코어 다이 면적을 잡아먹어 비트 밀도가 0.16 Gb/mm²(D1z DDR4는 0.296)에 그치고 12층 스택 수율이 다이 97% 기준 69.4%까지 떨어지기 때문에, 웨이퍼 투입 22%가 비트 9%로만 돌아오는 비대칭이 범용 D램을 함께 조입니다.

HBM 공급 부족, 원인은 정말 ‘AI 수요’뿐인가?
공급 부족을 만드는 두 축
첫째 축은 D램 셀 미세화가 물리 한계에 부딪혀 노드당 비트 밀도 향상폭이 줄었다는 점입니다. 공급을 늘리려면 공정을 미세화하는 대신 웨이퍼 투입량 자체를 늘려야 하는 상황이 됐습니다.
둘째 축은 그 한정된 웨이퍼를 HBM이 대량으로 가져간다는 점입니다. 어플라이드머티어리얼즈 CFO 브라이스 힐은 D램 웨이퍼 전체의 약 15%가 HBM에 할당된다고 밝혔습니다(뒤에 나오는 TrendForce의 18~22%는 상위 3사만 집계한 값입니다). 범용 D램 가격이 어떻게 움직였는지는 D램 13~18% 더 오른다: 노트북·스마트폰, 지금 사도 될까에서 따로 다뤘습니다.
HBM은 왜 굳이 다이를 수직으로 쌓아야 하나?
‘넓고 느린’ 인터페이스라는 설계 선택
HBM의 구조는 폭이 넓고 속도가 낮은 인터페이스입니다. Wevolver의 엔지니어링 가이드에 따르면 HBM3는 64비트 독립 채널 16개를 묶어 스택당 1024비트 폭을 구성하고 핀당 6.4Gbps로 동작하는데, GDDR6X가 유사한 성능을 내려면 핀당 최대 23Gbps가 필요합니다.
동작 방식은 단순합니다. 핀 하나의 속도를 낮추는 대신 핀 수를 늘려 총 대역폭을 맞추면, 신호를 밀어내는 데 드는 에너지가 줄어듭니다. 같은 자료 기준 HBM3는 2.5 pJ/bit, GDDR6X는 4.2 pJ/bit로, 비트당 에너지를 약 40% 줄입니다. HBM의 존재 이유는 절대 속도가 아니라 와트당 대역폭입니다.
문제는 이 설계가 곧 제약을 부른다는 점입니다. 1024비트, HBM4에서는 2048비트에 이르는 배선을 짧게 유지하려면 다이를 평면에 늘어놓을 수 없고 수직으로 쌓아야 합니다. 적층은 선택지가 아니라 이 인터페이스가 요구하는 조건이며, 이후 설명할 수율·박막화·열 문제는 모두 여기서 파생됩니다. 지멘스 EDA는 스택이 높아질수록 추가 열 저항이 생겨 수직 방향 열 확산이 어려워진다고 설명했습니다.
JEDEC 규격은 어떻게 확장되어 왔나
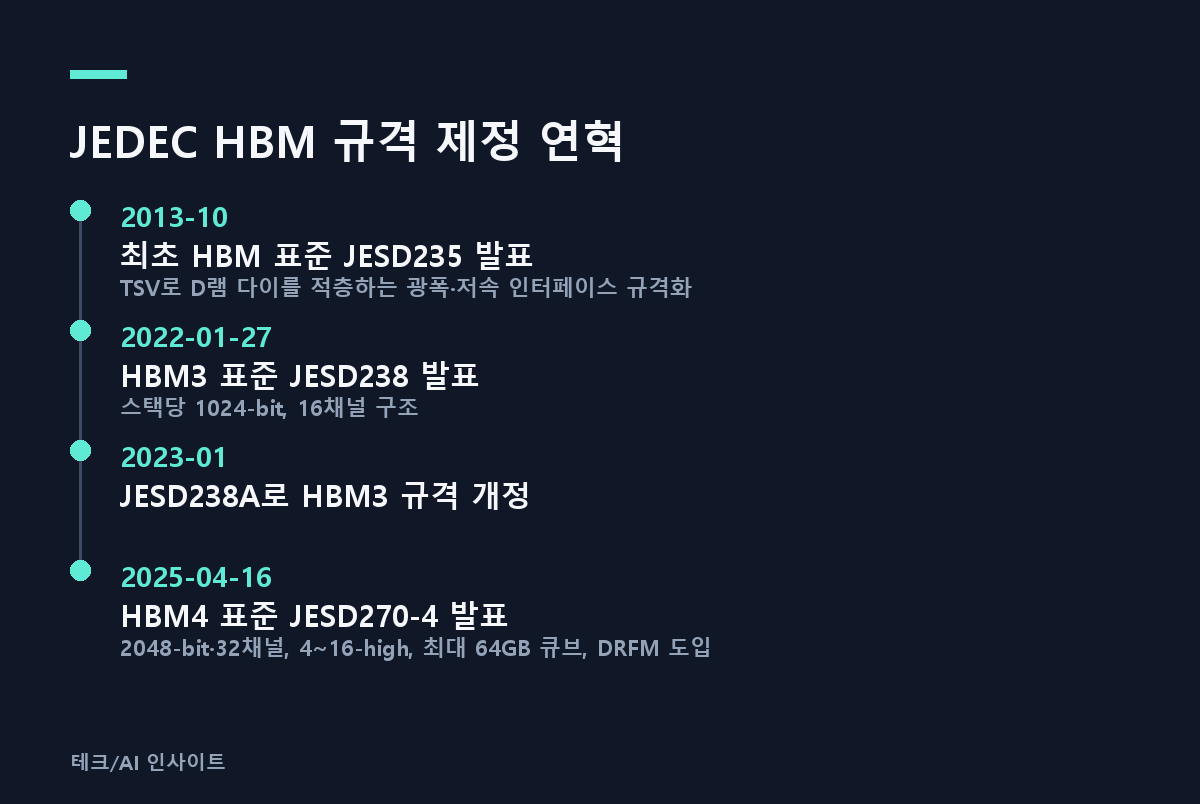
| 시점 | 규격 | 내용 |
|---|---|---|
| 2013-10 | JESD235 | 최초 HBM 표준. TSV로 D램 다이를 적층하는 광폭·저속 인터페이스 규격화 |
| 2022-01-27 | JESD238 | HBM3 표준. 스택당 1024비트, 16채널 구조 |
| 2023-01 | JESD238A | HBM3 규격 개정 |
| 2025-04-16 | JESD270-4 | HBM4 표준. 2048비트·32채널, 4~16-high 스택, 최대 64GB 큐브, DRFM 도입 |
JEDEC는 2025년 4월 16일 HBM4 표준 JESD270-4 발표를 공지하면서 2048비트 인터페이스에서 핀당 최대 8Gb/s, 스택당 최대 2TB/s 대역폭을 규정했습니다. 채널은 HBM3의 16개에서 32개로 두 배가 되고 채널당 의사채널(pseudo-channel) 2개를 둡니다.
같은 웨이퍼에서 나오는 비트는 왜 절반 이하인가?
TSV가 코어 다이 면적을 잡아먹는다
TSV(Through-Silicon Via, 실리콘 관통전극)는 실리콘 웨이퍼를 수직으로 뚫은 홀에 구리를 채운 구조입니다. SK하이닉스는 TSV를 여러 D램 칩에 수천 개의 구멍을 뚫어 수직 관통 전극으로 연결해 초고속 성능을 구현하는 핵심 기술이라고 설명합니다.
이 TSV 적층 구조가 만드는 대가가 면적입니다. 관통 전극을 배치하려면 코어 다이 안에 셀을 놓을 수 없는 영역이 생깁니다. SemiAnalysis에 따르면 SK하이닉스 D1z DDR4의 비트 밀도는 0.296 Gb/mm², HBM3는 0.16 Gb/mm²로 D1z DDR4가 HBM3보다 약 85% 높으며, 주된 원인이 TSV 배치에 필요한 추가 면적입니다.
웨이퍼 22%, 비트 9%의 비대칭
같은 웨이퍼 한 장에서 나오는 HBM 비트 밀도가 구조적으로 낮으므로, 라인을 HBM으로 돌리는 순간 전체 D램 비트 생산량이 줄어듭니다.
TrendForce의 전망을 연도별로 늘어놓으면 격차가 더 분명해집니다. 상위 3사의 HBM 웨이퍼 투입 비중은 2025년 말 약 18%, 2026년 말 약 22%, 2027년 말 약 30%인 데 비해 비트 공급 비중은 같은 기간 약 8%, 9%, 13%입니다. 투입은 늘어나는데 비트 기여는 그 절반 이하에 머무는 흐름이라, HBM 수요가 늘수록 범용 D램에 남는 비트가 비선형적으로 줄어듭니다.
범용 D램(평면)과 HBM(적층)의 구조 비교
| 항목 | 범용 D램(평면) | HBM(적층) |
|---|---|---|
| 비트 밀도 | D1z DDR4 0.296 Gb/mm² | HBM3 0.16 Gb/mm²(D1z DDR4가 약 85% 높음) |
| 수율 결정 구조 | 다이 단위 판정 | 층 곱셈(다이 99%→12층 87%, 97%→12층 69.4%), 기존 D램 대비 65%대 |
| 실패 지점 | 평면 단일 다이 | 12층 스택 내 수백만 개 TSV 중 하나만 불량이어도 스택 전체 폐기 |
적층 수율은 왜 곱셈으로 무너지나?
다이 2%p 차이가 스택에서 증폭된다
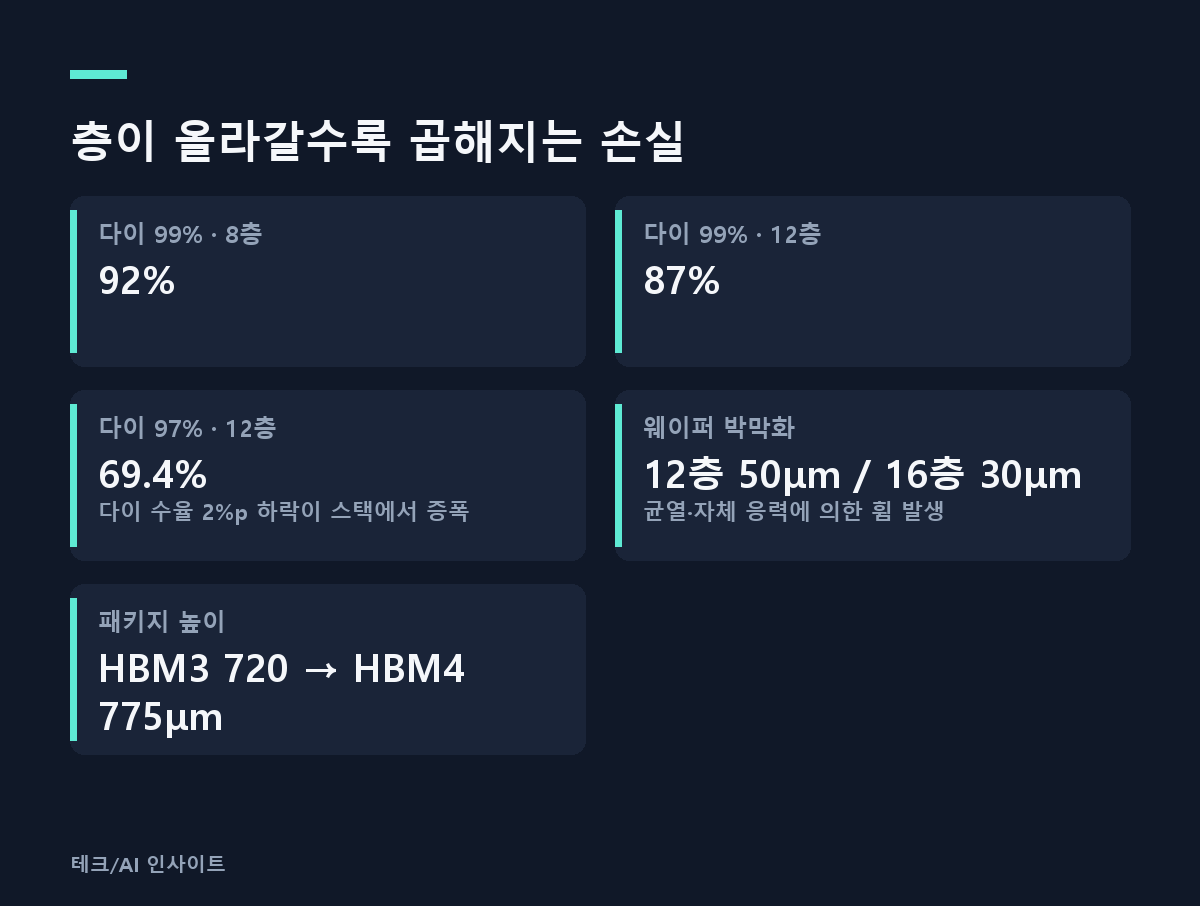
스택은 코어 다이 여러 장과 베이스 다이 한 장이 겹쳐진 구조이고, 판정은 스택 단위로 이뤄집니다. 적층 수율 계산은 층별 수율을 곱하는 방식이라 손실이 누적됩니다. SemiAnalysis 기준 다이 하나의 수율이 99%면 8층 스택은 92%, 12층은 87%로 떨어집니다. Damnang’s Substack의 계산에서는 다이 수율이 97%로 내려가면 12층 스택이 69.4%가 됩니다.
여기서 HBM 수율이 낮은 이유가 드러납니다. 공정 수가 많아서가 아니라 직렬 실패 지점이 많기 때문입니다. Damnang’s Substack의 정리에 따르면 12층 HBM 스택 하나에 수백만 개의 TSV가 들어가고, 그중 단 하나의 연결 불량이 칩 전체를 무효화합니다. 스택 안 다이 하나가 불량이면 함께 붙은 양품 다이까지 전부 폐기되므로, 단수를 올려 용량을 늘리려는 시도 자체가 웨이퍼 손실을 키웁니다. 딜사이트 보도에서는 HBM 수율이 기존 D램 대비 65%대 수준으로 낮다고 언급된 바 있습니다.
박막화 50μm·30μm에서 생기는 휨
층을 더 쌓으려면 웨이퍼를 얇게 갈아내야 합니다. 같은 자료 기준 12층 HBM은 약 50μm, 16층은 30μm 수준까지 박막화하는데, 이 두께에서는 균열이 쉽게 생기고 자체 응력으로 휨(warpage)이 발생합니다. 휜 웨이퍼는 HBM이 요구하는 정밀도로 접합될 수 없습니다. Damnang’s Substack은 층마다 열팽창계수가 달라 단수를 올릴수록 잔류 응력이 커진다는 점이 시뮬레이션에서 일관되게 확인된다고 설명했습니다.
하이브리드 본딩이 필요한 이유
여기에 패키지 높이라는 외부 제약이 겹칩니다. HBM 패키지 높이는 HBM3 720μm, HBM3E 725μm를 거쳐 HBM4에서 775μm로 완화됐습니다. 삼성전자는 제한된 775μm 폼팩터 안에 베이스 다이 1개와 코어 다이 16개, 총 17개 칩을 적층하려면 하이브리드 본딩으로 칩 간 갭을 최대한 줄여야 한다고 설명했습니다. 범프는 부피 때문에 높이를 줄이는 데 한계가 있고, 마이크로범프는 범프 쇼트 이슈로 피치를 좁히기 어렵습니다.
한계는 대안 쪽에 있습니다. SK하이닉스의 MR-MUF는 칩을 쌓은 뒤 칩 사이에 액체 보호재를 주입해 굳히는 공정으로 필름형 소재 대비 공정 효율과 열 방출에 유리하고, 어드밴스드 MR-MUF에는 기존 칩 두께 대비 40% 얇은 칩을 휘어짐 없이 적층하는 워피지 컨트롤이 적용됐습니다. 반면 범프를 없애 높이를 버는 하이브리드 본딩은 12층 이상에서 수율·계측·장기 신뢰성 문제가 아직 해결되지 않았습니다.
범용 D램은 왜 미세화로 물량을 못 늘리나?
커패시터 종횡비 100:1이라는 벽
D램 셀은 트랜지스터 하나와 커패시터 하나로 이뤄집니다. 셀이 작아지면 커패시터 직경이 줄어드는데, 전하를 담을 표면적을 유지하려면 높이를 키워 커패시터 종횡비를 계속 높이는 수밖에 없습니다. Semiconductor Engineering에 따르면 현재 커패시터는 높이 약 1,000nm에 직경은 수십 nm로 종횡비가 100:1에 접근하고 있습니다.
동작 단계에서 문제가 생기는 지점은 식각입니다. 고에너지 이온이 커패시터 홀을 파는 동안 하드마스크가 함께 깎이기 때문에, 종횡비가 높을수록 홀이 완성되기 전에 마스크가 침식돼 칩을 못 쓰게 될 위험이 커집니다. 그 결과 공급사들은 노드당 약 30%였던 전통적 스케일링 속도를 유지하지 못하고, 세대당 비트 밀도 향상은 약 15~25% 수준으로 줄었습니다.
EUV를 넣어도 밀도가 늘지 않은 이유
D램 미세화 한계는 리소그래피로 풀리지 않았습니다. SemiAnalysis는 10nm급 노드 진입 이후 D램 비트 밀도가 정체됐으며 삼성 1z·SK하이닉스 1a 노드에서 EUV를 도입했는데도 밀도가 크게 늘지 않았다고 정리합니다. 밀도 개선은 트랜지스터 축소가 아니라 더 높은 커패시터와 새로운 유전 물질 같은 커패시터 엔지니어링에서 나오고 있습니다. 전하 저장이라는 아날로그 요구가 병목이기 때문입니다.
그래서 업계는 셀 배치 구조 자체를 바꾸는 쪽으로 방향을 틀었습니다. 램리서치 더그 베팅거 CFO는 D램도 6F²에서 4F²로 넘어가고 결국 3D D램으로 진화할 것이라며, 6F²에서 4F²로 전환하면 웨이퍼당 칩 생산성이 약 20% 향상되고 장비 시장 규모는 1.7~1.8배 증가할 것으로 전망했습니다. 다만 4F²는 수직 채널 트랜지스터를 요구하고, 실리콘 채널 수직 트랜지스터는 D램에 필요한 엄격한 저누설 조건을 아직 충족하지 못한다는 점이 걸림돌입니다.
capex를 늘려도 공급이 빨리 풀리지 않는 이유는?
돈이 아니라 공간과 시간이 병목
공급 탄력성은 설비투자 금액이 아니라 클린룸 면적과 팹 가동 리드타임이 결정합니다. TrendForce는 DRAM capex가 2025년 537억 달러에서 2026년 613억 달러로 약 14% 늘어도 클린룸 용량이 제한적이라 2026년 비트 공급 증가에 미치는 영향은 최소 수준일 것으로 봤습니다. Micron의 미국 ID1 팹은 2027년 이전 가동이 어렵다고 전망했습니다.
투자비의 용처도 함께 봐야 합니다. 같은 자료는 투자 초점이 용량 확대보다 공정 업그레이드·고단 적층·하이브리드 본딩 같은 기술 전환으로 이동하고 있다고 설명했습니다. 늘어난 투자비 상당액이 ‘더 많은 웨이퍼’가 아니라 ‘더 어려운 제품’에 쓰인다는 뜻입니다.
기존 HBM 캐파도 새 팹에서 나온 것이 아닙니다. 딜사이트에 따르면 삼성전자 월 HBM 캐파는 2023년 2분기 2만5000장에서 2024년 4분기 15만~17만장 수준으로, SK하이닉스는 3만5000장에서 12만~14만장 규모로 늘 것으로 추정됐습니다. 기존 D램 라인을 전환한 물량이므로 그만큼 범용 D램 투입이 빠졌습니다.
세대 전환기마다 반복되는 램프업 공백
HBM4 2048-bit 32채널 전환은 설계를 처음부터 다시 하는 작업입니다. 지멘스 EDA는 인터페이스 배증으로 I/O 밀도가 높아져 지터 예산 관리가 복잡해지고, 컨트롤러·PHY IP·베이스 로직 다이가 모두 이전 세대와 호환되지 않아 완전히 새로운 설계가 필요하다고 정리했습니다. 세대가 바뀔 때마다 생산 램프업이 지연될 여지가 구조적으로 남아 있습니다.
자주 묻는 질문
HBM 수율은 일반 D램보다 얼마나 낮나요?
딜사이트 보도 기준 기존 D램 대비 65%대 수준으로 언급된 바 있습니다. 다만 이 숫자는 시점과 업체에 따라 달라지는 값이고, 구조적으로 중요한 것은 절대값보다 층수에 따라 곱해진다는 성질입니다. 다이 수율을 개선하면 스택 수율은 그보다 큰 폭으로 함께 좋아집니다.
HBM 웨이퍼 투입 비중이 늘면 범용 D램 공급은 얼마나 줄어드나요?
투입 비중이 늘어난 만큼 그대로 줄지 않고 그보다 크게 줄어듭니다. HBM은 같은 웨이퍼에서 내놓는 비트가 적기 때문에, 투입 비중과 비트 기여 비중의 차이만큼이 전체 비트 풀에서 사라지는 몫이 됩니다. TrendForce 전망대로 2027년 말 투입 30%·비트 13%가 되면 이 격차는 더 벌어집니다.
HBM4는 이전 세대와 무엇이 달라 생산이 더 어렵나요?
JEDEC의 JESD270-4는 채널을 32개로 늘리고 채널당 의사채널 2개를 두며, 24Gb/32Gb 다이 밀도와 4-high~16-high 스택을 지원해 32Gb 16-high 구성 시 큐브 용량 64GB까지 허용합니다. VDDQ 0.7/0.75/0.8/0.9V, VDDC 1.0/1.05V처럼 벤더별 전압 옵션이 열려 있고 로우해머 완화용 DRFM(Directed Refresh Management)이 들어갔습니다. 선택지가 넓다는 것은 검증해야 할 조합도 늘어난다는 뜻입니다.
16단 HBM부터 하이브리드 본딩이 필수라는 말은 무슨 뜻인가요?
정해진 패키지 높이 안에 칩을 더 넣으려면 칩 사이 간격을 줄여야 하는데, 범프 방식으로는 그 간격을 더 줄이기 어렵다는 뜻입니다. 결국 남는 해법이 범프를 없애고 접합면을 직접 맞붙이는 방식입니다.
D램 공장을 더 지으면 공급 부족은 언제쯤 풀리나요?
신규 팹은 발표 시점이 아니라 가동 시점이 기준입니다. TrendForce가 Micron ID1 팹의 2027년 이전 가동이 어렵다고 본 것처럼, 착공과 양산 사이에는 클린룸 준비와 장비 반입이라는 시간이 들어갑니다. 증설 뉴스를 읽을 때는 금액보다 가동 예정 시점과 그 라인이 HBM용인지 범용인지를 먼저 확인하는 편이 유용합니다.
3D D램이나 4F² 구조가 나오면 비트 공급이 다시 늘어나나요?
램리서치 전망대로라면 4F² 전환만으로 웨이퍼당 칩 생산성이 약 20% 향상됩니다. 다만 이는 조건부입니다. 4F²가 요구하는 수직 채널 트랜지스터가 D램의 저누설 요구를 충족해야 하고, 그 조건이 아직 풀리지 않았다는 점은 기술 발표를 볼 때 함께 확인할 부분입니다.
함께 읽기
참고 자료
- JEDEC and Industry Leaders Collaborate to Release JESD270-4 HBM4 Standard — JEDEC
- Tight DRAM Supply Gives Suppliers Greater Pricing Power in HBM — TrendForce
- Memory Industry to Maintain Cautious CapEx in 2026 — TrendForce
- Why HBM Is So Hard to Make — Damnang’s Substack
- Scaling the Memory Wall: The Rise and Roadmap of HBM — SemiAnalysis
- DRAM Scaling Challenges Grow — Semiconductor Engineering
- The Memory Wall: Past, Present, and Future of DRAM — SemiAnalysis
- HBM3e and HBM4: IC design guide for next-generation high bandwidth memory — Siemens EDA
- SK하이닉스 이규제 부사장 “차세대 패키징 기술로 HBM 1등 성공신화 이어갈 것” — SK하이닉스 뉴스룸
- [반도체 쇼티지] HBM 웨이퍼 투입 폭증, 삼성전자 낙수효과? — 딜사이트
- What is High Bandwidth Memory 3 (HBM3): Complete Engineering Guide — Wevolver