오라이온은 무엇을 해결하려는 설계인가?
오라이온(Oryon)은 Arm 명령어 집합(ISA, Instruction Set Architecture — CPU가 해석하는 명령어의 규격)만 공유하고 파이프라인·실행 유닛·캐시·분기 예측기는 따로 설계된 코어입니다. 스펙표에 나란히 적히는 8-wide 디코드, 680엔트리 ROB, 16MB 캐시, 5.0GHz는 각각 독립된 항목이 아니라 하나의 교환 관계로 묶여 있습니다. 폭을 넓히면 뒤쪽을 함께 키워야 하고, 캐시 용량을 키우면 접근 지연이 늘고, 클럭을 올리려면 전압이 따라 올라갑니다.
그래서 오라이온 CPU 아키텍처를 읽는 기준은 “숫자가 얼마나 큰가”가 아니라 “이 숫자를 키우려고 어떤 숫자를 내줬는가”입니다.
한 줄 요약: 오라이온은 Arm ISA만 공유하는 자체 마이크로아키텍처로, 1세대 8-wide·680엔트리 ROB에서 3세대 9-wide·클러스터 L2 16MB로 폭과 용량을 함께 키웠지만 L2 히트 지연은 17→21사이클로 늘었고, 프라임 5.0GHz는 2코어 부스트 조건에서만 성립합니다.
아키텍처 라이선스와 코어 라이선스 차이
두 코어가 같은 명령어를 실행하면서 내부는 전혀 다를 수 있는 근거는 라이선스 종류입니다. 안드로이드오소리티의 정리에 따르면 코어 라이선스는 Cortex-A처럼 완성된 CPU 설계를 SoC에 통합할 권리만 주고 설계 수정은 허용하지 않는 ‘기성품’입니다. 아키텍처 라이선스는 Arm ISA와 호환되기만 하면 파이프라인 깊이·캐시 계층·실행 유닛을 전부 자체적으로 정할 수 있게 하며, 대신 Arm의 컴플라이언스 테스트를 통과해야 합니다.
톰스하드웨어에 따르면 리드 개발자 Gerard Williams III는 최종 설계에 Arm이 개발한 기술이 ‘1% 이하’ 들어갔다고 진술했습니다. 2024년 12월 배심은 퀄컴이 Arm의 아키텍처 라이선스 계약(ALA)과 기술 라이선스 계약(TLA)을 위반하지 않았다고 만장일치로 판단했고, RCR 와이어리스 뉴스에 따르면 2025년 10월 1일 델라웨어 연방지법은 퀄컴도 누비아도 ALA를 위반하지 않았다며 남은 청구를 기각했습니다.
자유롭게 설계할 수 있는 범위는 내부 구조이고, 외부로 드러나는 명령어 동작은 규격에 묶여 있습니다. 즉 오라이온은 같은 명령어를 실행하는 다른 기계입니다.
오라이온 세대별 구조 변화
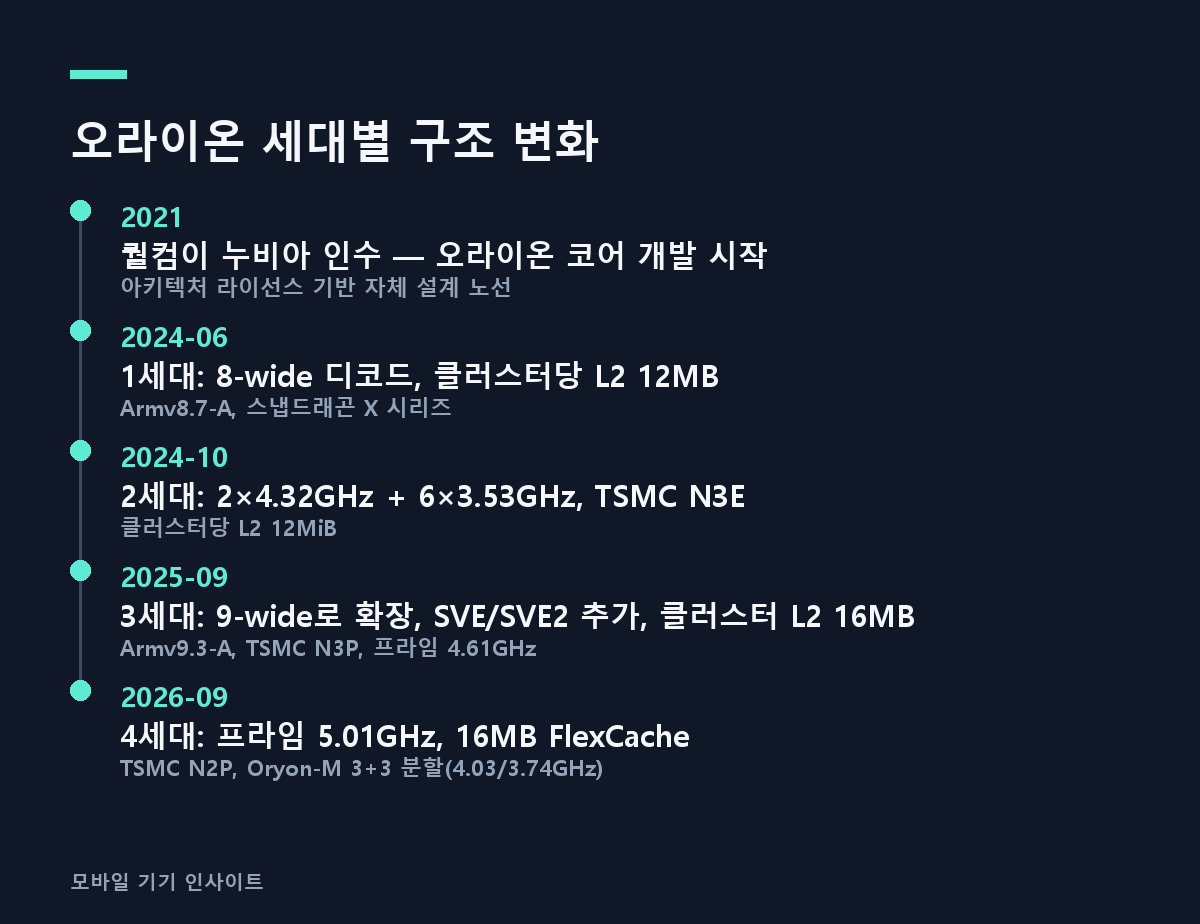
위키피디아 기준으로 1·2세대는 ARMv8.7-A를, 3세대는 ARMv9.3-A를 구현하며, 누비아 인수는 2021년입니다.
| 항목 | 1세대 오라이온(스냅드래곤 X Elite) | 3세대 오라이온(스냅드래곤 X2 Elite) |
|---|---|---|
| 디코드/리네임/리타이어 폭 | 8-wide | 9-wide |
| 리오더 버퍼(ROB) | 680엔트리 | 650+엔트리 |
| 구현 명령어 집합 | Armv8.7-A | Armv9.3-A |
| 벡터 확장 | 고정 폭 방식 | SVE/SVE2 추가, 128b 벡터 레지스터 400개 이상 |
| 브랜치 유닛 | 2개 | 4개(1세대의 두 배) |
| 클러스터 L2 | 12MB | 16MB 16-way |
| L1 미스→L2 히트 지연 | 17사이클 | 21사이클 |
8-wide 디코드는 왜 Arm 계열에서 현실적인가?

디코더는 메모리에서 끌어온 바이트 열을 실행 가능한 명령어로 잘라내는 장치입니다. 8개를 한 사이클에 자르려면 “어디서부터가 명령어인가”를 8곳에서 동시에 판단해야 하는데, 이 비용이 명령어 인코딩 방식에 따라 크게 갈립니다. 에모리대 CS 255 강의 자료는 고정 길이 명령어의 이점을 이렇게 설명합니다. 명령어 길이가 페치 윈도우에 정렬되므로 하나의 명령어를 모으려고 여러 번 페치할 필요가 없고, 윈도우 안에서 시작 위치가 고정되며 그 수도 적습니다. 반대로 x86의 가변 길이 명령어는 스트림을 스캔해 길이를 알아내야 하고, 시작 가능 위치가 하나 늘 때마다 대체로 헛일을 하는 병렬 디코더를 하나 더 붙여야 합니다.
그래서 8-wide 디코드는 고정 4바이트 인코딩 위에서 상대적으로 값싸게 성립하는 선택입니다. 실행 순서는 이렇습니다.
- 명령어 캐시에서 사이클당 64바이트, 즉 4바이트 명령어 16개 분량을 페치합니다.
- 1세대는 8-wide, 3세대는 9-wide로 디코드하고 리네임합니다.
- 3세대 기준 정수 6×20=120엔트리, 벡터 4×48=192엔트리 스케줄러에 올려 실행 유닛으로 보냅니다.
- ROB에서 원래 프로그램 순서대로 리타이어합니다. 3세대는 리타이어 폭도 9-wide입니다.
Hot Chips 2024에서 공개된 내용에 따르면 조건 분기 예측기는 TAGE 방식에 80KB의 저장 공간을 배정했습니다. L1 데이터 캐시가 96KB인 것과 맞먹는 규모를, 데이터가 아니라 “다음에 어디로 갈지”를 기억하는 데 씁니다. 분기 오예측 패널티가 13사이클이기 때문입니다. Williams는 넓은 페치가 “분기 오예측 후 파이프라인을 더 빨리 채우는 데 도움이 됐다”고 설명했습니다.
넓은 프론트엔드의 이득은 예측이 맞는 동안에만 누적되고, 틀리는 순간 13사이클치 작업이 버려집니다.
폭을 넓히면 무엇을 함께 키워야 하나?
680엔트리 ROB의 리오더 버퍼 역할
칩스앤치즈는 오라이온을 “매우 높은 재정렬 능력을 가진 8-wide 코어”로 설명하며 680엔트리 ROB와 384엔트리 정수/부동소수점 물리 레지스터 파일을 제시합니다. ROB(Re-Order Buffer, 실행을 순서와 무관하게 하더라도 결과를 원래 순서로 되돌리기 위해 명령어를 줄 세워두는 대기열)는 넓은 디코드의 짝입니다. 명령어를 많이 끌어와도 ROB와 레지스터 파일이 충분히 깊지 않으면 창이 금방 막히므로, 폭과 깊이를 함께 키운 것이 이 오라이온 코어 구조의 골자입니다.
주소 변환도 같은 이유로 확장됐습니다. 224엔트리 L1 DTLB 위에 8K엔트리 L2 TLB를 올리고, 페이지 워크를 10~20건 동시에 진행할 수 있게 했습니다. 큰 데이터 풋프린트를 다룰 때 TLB 미스가 하나씩 직렬화되면 앞단이 벌어놓은 여유가 무의미해지기 때문입니다.
3세대에서는 폭에 맞춰 뒤쪽도 다시 늘었습니다. 정수 ALU 6개(2개는 곱셈, 1개는 크립토·제산 담당), 4개의 128b FMA 가능 벡터 ALU, 그리고 1세대의 두 배인 브랜치 유닛 4개입니다. 폭이 넓어질수록 한 사이클에 처리해야 할 분기 수도 함께 늘어납니다.
다만 위 표의 ROB 값은 그렇게 읽을 수 없습니다. 3세대 수치는 ‘650+ 엔트리’라는 하한 표기여서, 1세대의 680엔트리와 같은 기준에 놓고 재정렬 창이 줄었다고 판단할 근거가 되지 못합니다.
프리페처가 통하는 조건과 통하지 않는 조건
칩스앤치즈는 오라이온의 프리페처가 선형 접근 패턴에서 “충분히 앞서 달려 L2 지연을 거의 완전히 숨긴다”고 적었습니다. 그 결과 단일 스레드 DRAM 대역폭이 약 100GB/s에 달하는데, 같은 조건에서 측정한 비교 코어들은 약 30GB/s 수준입니다. 이 이득은 선형 접근에 붙은 값이어서 불규칙한 포인터 추적에서는 사라집니다. 코어 바깥 메모리 쪽 규격은 LPDDR5X 구조 정리: 데이터는 8533Mbps인데 커맨드 클럭은 800MHz인 이유에서 따로 다뤘습니다.
칩스앤치즈는 구조적 비대칭도 지적합니다. 로드 큐는 192엔트리인데 스토어 큐는 56엔트리여서, 쓰기가 많은 코드에서는 로드 쪽 여유가 남아도 스토어 큐가 먼저 차서 디스패치가 멈출 수 있습니다.
클러스터 L2 12MB에서 16MB FlexCache로, 무엇이 바뀌었나?
1세대 캐시 계층은 L1 데이터 96KB, L1 명령어 192KB, 4코어 클러스터당 L2 12MB, 시스템 레벨 캐시 6MB(26~29ns) 구성입니다. Hot Chips 2024 설명에 따르면 초기 개발 단계에서 L2 인터커넥트가 4코어로 제한되어 있었고, 더 큰 클러스터를 지원하는 설계는 나중에 추가됐지만 스냅드래곤 X Elite에는 들어가지 못했습니다.
3세대를 쓴 스냅드래곤 X2 Elite는 클러스터 L2를 16MB 16-way로 키웠고, 그러자 L1 미스→L2 히트 지연이 스냅드래곤 X Elite의 17사이클에서 21사이클로 늘었습니다. 칩스앤치즈는 그 원인을 구조가 커졌기 때문이라고 명시합니다. 용량과 접근 지연은 맞바꾸는 관계이며, 용량을 늘리는 선택은 워킹셋이 커서 미스율 감소 이득이 지연 증가를 덮을 때만 타당합니다. 이 클러스터 L2는 코어당 사이클당 64B, 클러스터 합계 최대 256B/사이클의 필 대역폭을 제공하고 코어와 같은 클럭으로 동작합니다.
FlexCache 동작 방식
모바일 쪽은 축이 다릅니다. 나무위키의 세대별 정리 기준으로 8 Elite와 8 Elite Gen 5는 클러스터당 L2 12MiB였고, 2026년 9월 8 Elite Gen 6에서는 CPU 전체가 16MiB를 공유하는 구성으로 바뀌었습니다. GSMArena는 이 구성을 “16MB의 오라이온 FlexCache”로 표기합니다. 즉 X2 Elite의 16MB 16-way 클러스터 L2와 Gen 6의 16MB FlexCache는 서로 다른 칩의 서로 다른 구성이며, 앞의 17→21사이클은 전자의 값입니다.
Oryon-M은 왜 클럭만 낮춘 코어가 아닌가?
Oryon-M이 대형 코어(Oryon-L)에서 덜어낸 것
오라이온은 하나의 코어를 클럭만 낮춰 쓰는 방식이 아니라, 같은 ISA를 구현하는 두 개의 다른 마이크로아키텍처를 씁니다. 스냅드래곤 8 Elite에 쓰인 Oryon-M은 마이크로아키텍처 다이어그램 정리 기준으로 대형 코어 대비 8-wide 대신 4-wide 디코드, 정수 파이프라인 6개 대신 4개, 로드/스토어 파이프라인 4개 대신 2개, FP/SIMD 파이프라인 4개 대신 2개입니다. 폭을 줄이면 프론트엔드와 스케줄러의 고정 전력이 함께 줄어들어 저전력 구간의 전력당 성능이 유리해집니다.
Gen 6에서는 여기에 한 층이 더 붙었습니다. Oryon-M 6개를 3+3 두 그룹으로 쪼개 4.03GHz와 3.74GHz라는 서로 다른 주파수 도메인에 둔 것입니다.
5.0GHz가 그대로 체감되지 않는 조건은?
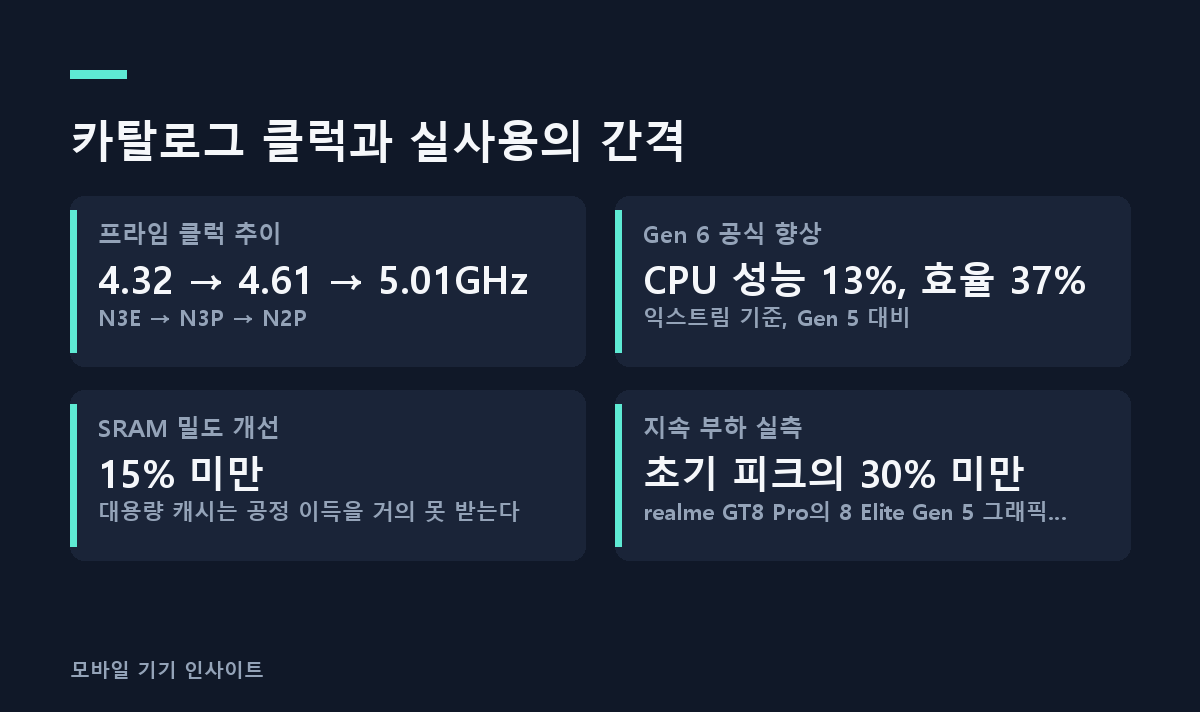
클럭이 세대마다 올라가는 경로는 전력 식으로 설명됩니다. 펜실베이니아대 CIS 501 강의 자료에 따르면 동적 전력은 P=CfV²이고, 주파수를 올리려면 사이클 타임이 짧아져 크리티컬 패스를 더 빠른 트랜지스터로 통과해야 하므로 전압을 함께 올려야 합니다. 전압이 제곱으로 들어가기 때문에 전압 15% 감소는 동적 전력 약 40% 감소가 됩니다. 새 공정이 같은 주파수를 더 낮은 전압으로 낼 수 있게 되면 그 여유를 다시 클럭으로 쓸 수 있고, 프라임 클럭이 4.32GHz(N3E) → 4.61GHz(N3P) → 5.01GHz(N2P)로 오른 것이 이 교환의 결과입니다.
2nm에서의 물리적 변화는 트랜지스터 구조 교체입니다. 톰스하드웨어에 따르면 N2는 TSMC 최초로 GAA(Gate-All-Around, 게이트가 채널을 완전히 둘러싸는 구조) 나노시트를 채택해 전계 제어를 개선하고 누설을 줄이며, N3E 대비 동일 전력에서 10~15% 성능, 동일 성능에서 25~30% 전력 감소, 로직·아날로그·SRAM 혼합 설계에서 트랜지스터 밀도 15% 증가(로직 전용은 최대 20%)를 목표로 합니다.
성능 10~13%인데 효율 37%인 배분
퀄컴이 Gen 6에서 공식 제시한 수치는 Gen 5 대비 익스트림 CPU 성능 13%·CPU 전력 효율 37%, 표준형 CPU 성능 10%·효율 37% 향상입니다. 2nm와 GAA 전환이라는 세대급 공정 변화에도 CPU 성능 향상이 10%대에 머무는 대신 효율 향상이 37%로 훨씬 큰데, 이는 확보한 공정 여유를 클럭보다 전력 쪽에 더 많이 배분했음을 뜻합니다.
공정 이득이 오지 않는 영역도 분명합니다. 세미컨덕터 엔지니어링에 따르면 2nm 이하 선단 공정에서 SRAM 비트셀 밀도 개선은 15% 미만으로 떨어졌고, 이는 65nm에서 5nm까지 세대마다 50~100%씩 줄어들던 것과 대조됩니다. 배선 저항과 비트라인 커패시턴스 증가로 SRAM 속도도 정체됐으며, 로직은 디바이스·라우팅 혁신으로 계속 스케일링됐지만 SRAM은 그러지 못했습니다. 그래서 16MB FlexCache나 클러스터당 16MB L2 같은 대용량 캐시는 노드가 바뀌어도 면적·비용 부담이 거의 그대로 남습니다.
2코어 부스트, 지속 부하, 배터리 구동
5.0GHz는 조건부 값이어서, 같은 칩이라도 기기에 따라 체감이 크게 갈립니다. GSMArena에 따르면 Gen 6 두 칩의 코어 구성은 “최대 5.0GHz 프라임 코어 2개와 최대 4.0GHz 퍼포먼스 코어 6개”로, 5.0GHz는 프라임 2개에 걸리는 값입니다. 폰아레나의 realme GT8 Pro 테스트에서는 8 Elite Gen 5가 까다로운 그래픽 테스트에서 초기 피크의 30% 미만까지 떨어졌고, 일부 기기는 스트레스 테스트 종료 시점에 50% 이상 성능이 하락했습니다. 30% 미만이라는 수치는 단일 기기 한 대의 측정 결과입니다. 노트북 쪽에서도 칩스앤치즈 측정에서 배터리 구동 시 갤럭시 북4가 평균 2.71GHz로 동작했습니다.
자주 묻는 질문
오라이온은 Arm 코어인가요, 퀄컴 자체 설계인가요?
명령어 집합은 Arm의 것이고 회로는 퀄컴(누비아) 설계입니다. 판단 기준은 라이선스 종류이며, 아키텍처 라이선스 보유자는 Arm의 컴플라이언스 테스트를 통과하는 한 내부를 자유롭게 정할 수 있습니다.
디코드 폭이 8에서 9로 늘면 성능은 얼마나 올라가나요?
공개된 것은 폭과 엔트리 수이고, 폭만으로 성능 증가율을 계산할 수는 없습니다. 3세대는 디코드뿐 아니라 리네임과 리타이어도 9-wide로 함께 넓혔습니다. 리타이어 폭이 같이 늘지 않으면 앞단을 넓혀도 명령어가 ROB에서 빠져나가는 속도에 걸립니다.
캐시가 커지면 왜 지연이 같이 늘어나나요?
용량이 커지면 찾아야 할 범위와 배선 거리가 함께 늘어나고, 칩스앤치즈는 3세대의 지연 증가 원인을 구조가 커졌기 때문이라고 적었습니다. 여기에 배선 저항과 비트라인 커패시턴스가 늘어 SRAM 속도 자체가 정체된 사정이 겹칩니다.
FlexCache는 기존 클러스터 L2와 무엇이 다른가요?
경계가 다릅니다. 8 Elite와 8 Elite Gen 5는 클러스터당 L2 12MiB였고, Gen 6은 CPU 전체가 16MiB를 공유합니다.
프라임 코어 5.0GHz는 실제로 얼마나 유지되나요?
최대 2개 프라임 코어에 걸리는 부스트 값이고, 지속 부하에서는 열 한계가 먼저 옵니다. 같은 칩이라도 기기별 편차가 커서, 8 Elite Gen 5 스트레스 테스트에서는 종료 시점에 50% 이상 하락한 기기도 보고됐습니다. 클럭 숫자는 칩의 상한이고, 몇 분 뒤의 성능은 기기의 방열 설계가 정합니다.
SVE/SVE2가 추가되면 기존 앱은 바로 빨라지나요?
SVE의 설계 의도는 벡터 길이를 하드웨어가 정하고 코드는 길이에 무관하게 작성되도록 하는 것이어서, 같은 바이너리가 벡터 폭이 다른 후속 코어에서도 그대로 돌아갑니다. 이 성질은 앱 실행 속도보다 세대가 바뀔 때의 재작성 부담 쪽에서 먼저 드러납니다.
함께 읽기
- 퀄컴 칩값 인상 9월 1일 발효: 플래그십 10~15%, 내 폰 값에 붙는 시점은 따로 있다
- HBM 공급 부족 원인: 웨이퍼 22%를 쓰고 비트는 9%만 나오는 구조
- 엑시노스 2700 vs 스냅드래곤 8 엘리트 6세대: 멀티코어 9.5% 앞서고 싱글코어는 밀리는 이유
참고 자료
- Hot Chips 2024: Qualcomm’s Oryon Core — Chips and Cheese
- Qualcomm’s Oryon Core: A Long Time in the Making — Chips and Cheese
- Qualcomm’s Snapdragon X2 Elite — Chips and Cheese
- Oryon — Wikipedia
- Qualcomm says its Oryon CPU cores have 1% or less of Arm’s original technology — Tom’s Hardware
- Custom CPU cores vs Arm Cortex cores — Android Authority
- TSMC begins quietly volume production of 2nm-class chips — Tom’s Hardware
- Snapdragon 8 Elite Extreme Gen 6 and 8 Elite Gen 6 debut — GSMArena
- 퀄컴 스냅드래곤/8 시리즈/8 Elite — 나무위키
- Qualcomm Oryon — CPU Microarchitecture Diagrams — jia.je
- SRAM Scaling Issues, And What Comes Next — Semiconductor Engineering
- The Snapdragon 8 Elite Gen 5 is fast, but not all phones can handle the heat — PhoneArena
- CIS 501 Lecture 12: Power — University of Pennsylvania
- ‘Full and final judgment’ reached in Qualcomm vs. Arm case — RCR Wireless News
- Fixed length and variable length instruction codes — Emory University CS 255